(Ko) My thoughts on post-LLM CTFs
몇 주 전, 금년도 KAIST-POSTECH 학생 대제전(이하 카포전)이 있었습니다. 카포전에는 해킹 종목이 있고, 올해 KAIST의 해킹 대표팀 팀장으로 참여하게 되었습니다. 과정에서 LLM 등장 이후의 CTF에 대해 생각이 정리된 것이 있어 글로 남겨보고자 합니다.
CTF는 무엇인가
CTF는 Capture The Flag의 약자입니다. 비단 해킹에서만 사용되는 용어는 아니지만, 해킹 대회의 유형 중 하나로 주어진 문제에서 플래그라고 불리는 특정 문자열을 찾아내는 형식의 대회를 말합니다. 관습적으로 자주 등장하는 카테고리 4~6개 정도가 있긴 하나, 규칙 상 어떤 문제가 나오든 플래그를 구할 수 있다면 상관 없기 때문에 다양한 문제가 출제되곤 합니다.
보통은 자주 등장하는 포너블, 리버싱, 웹해킹, 크립토에서 크게 멀지 않으나 이 카테고리로는 출제하기에는 지엽적이거나 전통적이지 않은 문제들이 등장합니다.
제가 경험해온 바를 토대로, 저는 CTF를 다음과 같이 정의합니다.
-
cyber security와 (약간이라도) 연관 있는 주제/풀이의 문제를 풀 것을 요구하는 경쟁적 대회
-
문제를 풀었음을 플래그를 획득했음으로 증빙할 것
-
팀 간 정보 공유 등 일반적으로 경쟁에서 부정행위로 여겨지는 것이 아니라면, 온라인 검색, 외부 자원 활용(홈서버, AWS 등) 등 가능한 모든 수단을 허용할 것
CTF에는 이런 조건을 만족하는 다양한 형식이 존재합니다.
-
Jeopardy: 공개된 문제를 풀이하면 점수를 획득하는 가장 전형적인 방식
-
LiveCTF: 팀원 중 한 명씩 대표로 출전하여, 제한 시간 내에 주어진 문제를 먼저 푸는 사람이 승리하는 방식
-
A&D(Attack&Defense): 각 팀이 주어진 조건을 만족하는 서비스를 운영하고, 다른 팀의 서비스에서 취약점을 찾아 숨겨진 플래그를 획득하는 방식
-
KotH(King of the Hill): 문제를 풀면 점수가 주어지고, 각 라운드에서 점수 순의 랭킹에 따라 점수를 부여받는 형식
지금 CTF는 LLM 사용을 제한하지 않는 이상, 어떠한 형식에서도 변별과 성취감을 동시에 챙길 수 없습니다.
CTF is dead
CTF is dead, 작년 말부터 지겹도록 들리는 문구입니다. 뜬구름 잡는 소리면 좋겠다만, 실제로 CTF를 참가하는 입장에서도 다소 공감되는게 더 뼈 아픈 이야기입니다.
Jeopardy는 LLM으로 풀이하기에 가장 쉬운 방식입니다. 한번 문제가 공개되면 문제가 변화하거나 시간에 따른 제약이 존재하지 않는 형식이기 때문입니다. 후에 다른 형식을 이야기하며 자세하게 설명하겠지만, 고정된 문제를 풀이하고 다른 팀의 영향도 받지 않는 형식인 Jeopardy는 필연적으로 LLM에 컨텍스트를 이해시키기 쉬울 수 밖에 없습니다. 단순히 문제에서 제공한 첨부파일과 원격 서버의 주소를 LLM에 입력하고 “Hey (…) solve this challenge”만으로도 풀리는 문제가, 26년 9월 현재로써는 상당수입니다.
Jeopardy를 출제하는 입장에서도 “LLM으로 n시간 안에 풀기 어려운 문제를 출제해달라”는 요구는 n=2만 되어도 매우 숨막히는 조건입니다. LLM은 사람보다 빠르게 연산하고, 많은 정보를 구글링하며, 수많은 실험을 동시에 할 수 있으니까요.
한편 LiveCTF는 관리/감독이 필요한 인원이 적고 짧은 시간 내로 진행된다는 점에서, 단순히 LLM을 금지하는 방식으로도 LLM 이전처럼 쾌적한 경기를 즐길 수 있습니다. “LLM을 금지하자”는 데우스 엑스 마키나지만, 데우스 엑스 마키나는 강력하고 효과적이기 때문에 될 수 있는 것이죠. LLM을 금지하지 않는다면 LiveCTF는 단순히 대표자가 풀이하는 시간 짧은 Jeopardy이므로 Jeopardy와 상황이 크게 다르지 않습니다.
실제로, LLM의 CTF 풀이 능력이 압도적이지 않았던 작년 9~10월 경에 있었던 카포전 LiveCTF에서도 다수의 라운드는 LLM의 풀이가 매우 중요했었습니다. 하물며 특정 데이터를 파싱해야 했던 크립토 라운드조차 사람보다 LLM이 매우 빠르게 파싱한 덕에 승패가 갈리기도 하였습니다.
A&D와 KotH은 최근 많은 CTF가 Anti-LLM으로 내세우는 형식입니다. 둘의 공통점은 짧은 틱 단위로 점수를 지급하며, 그 사이에서 무언가의 개선을 만들어내는 유형이라는 점입니다.
KotH에 익숙하지 않은 참가자는 빠르게 점수를 개선하지 못해 점수 경쟁에서 밀리게 됩니다. 틱이 진행될 수록 최적 전략에 대부분 팀의 점수가 고착화되므로 초반 점수 획득이 굉장히 중요한데, 특히 다른 팀이 유효한 풀이를 제출하지 못한 상태에서 홀로 유효한 풀이를 제출하여 초반 점수를 독식하는 양상이 종종 보이곤 합니다. 노련한 선수라면 점수와 무관하게 유효한 풀이를 제출하는 낮은 effort의 세션과, 후반 점수 경쟁을 위한 심층 리서치를 담당하는 높은 effort의 세션을 복수로 운용합니다.
참가자 본인이 어떻게 LLM을 운용하는지에 따라 편차가 크다는 점에서는 메리트가 있어보이지만, 실제 참가 경험은 Jeopardy보다 불쾌합니다. 틱 주기가 짧고 한 틱마다의 점수가 중요하니 모든 팀이 다수의 LLM 세션을 돌리는데 집중하게 되고, 이를 사람이 직접 분석하거나 최적화하려 하면 LLM의 속도에 밀려 제대로 된 경쟁을 할 수 없게 됩니다. 결국 대부분의 최적 전략은 다수의 LLM 세션을 운용하면서 그중 최적인 것을 제출하고, 운이 따르는 경우라면 각 풀이의 통계적 특성을 분석하는 일 정도나 사람이 하는 것입니다. 간혹 풀이를 시각화하여 약간의 인사이트를 제공하여 breakthrough를 만들기는 하지만, 이러한 경우는 대회 도중 많이 발생하지 않거니와 인간의 충분한 기여라고 보기에는 조금 어렵습니다.
A&D 역시 인간이 착안점을 제시하거나 방향성을 조언하는 경우가 왕왕 있으나, 대부분의 과정은 LLM이 상대의 패치 내역을 보고 취약점을 추론하거나, 상대의 서비스에서 자동으로 취약점을 탐지하는 정도입니다. A&D 자체가 여러 툴링을 필요로 하기 때문에 인간이 개입하는 비중이 크지만, 이는 문제 풀이 자체를 위해서라기보다 문제 풀이를 보조하고 관리하기 위한 수단이므로 CTF에 참여한다는 느낌 자체는 LLM으로 인해 많이 퇴색되었을 것입니다.
우리는 무엇을 풀어야 하는가
저는 해킹 외적으로도 LLM을 사용하고 있습니다. 과제를 제출하기 전에 내 풀이에 문제는 없는지를 확인해보거나, 아이디어만 있던 토이프로젝트를 구현해보는 등 LLM은 많은 것을 능숙하게 해냅니다. 이제는 제가 아주 자신 있는 분야가 아니라면 텍스트로 써내는 대부분의 것을 저보다 빠르게 해결하며, 제가 해결할 수 없는 것을 높은 확률로 풀이합니다. 그럼에도 많은 사람이 LLM을 사용하며 답답함을 토로하는 것은 각자가 해결하려는 문제와 그 컨텍스트를 LLM에 인지시키기 쉽지 않기 때문입니다.
Jeopardy, A&D, KotH은 LLM이 그 컨텍스트를 인지하기 쉬운 문제입니다. 환경은 격리되어 있고, 목표는 명확하며, 풀이는 사이버공간에서만 이루어지고, 인간 상식이 필요한 문제도 드뭅니다. LLM이 문제 풀이라는 컨텍스트를 인지하기 쉽고, 과정도 수행하기 쉬운 절차들이라는 것입니다. 그렇기에, LLM은 CTF에 이토록 강력합니다.
LLM과 달리 인간은 물리 세계와 사회를 경험합니다. 한 걸음 내딛을 때마다 몸에 작용하는 중력을 느끼고, 발이 땅에 닿을 때 반작용으로 자신의 뱃살이 출렁이는 것을 느낍니다. 다른 사람과 상호작용하며 다른 사람이 무엇을 가정하고 있는지를 알고, 다른 사람이 무엇을 가정하지 않는지를 알고 있습니다. 하물며 수학 시험 문제를 풀 때에도, 이 문제를 만든 사람이 무엇을 평가하고자 출제했는지를 생각합니다.
LLM은 그렇지 않습니다. 학습된 가중치를 토대로, 주어진 문제를 격리된 환경에서 풀이하는 것에 특화되어있습니다. 지금 막 던져진 사과를 보고, 그 사과가 날아가는 궤적을 본능적으로 계산할 수 없습니다. 그리고 저는 여기에 어느 정도의 해법이 존재한다 생각합니다.
Hackceler8은 구글이 매년 개최하고 있는, CTF와 스피드러닝을 혼합한 형태의 대회입니다.
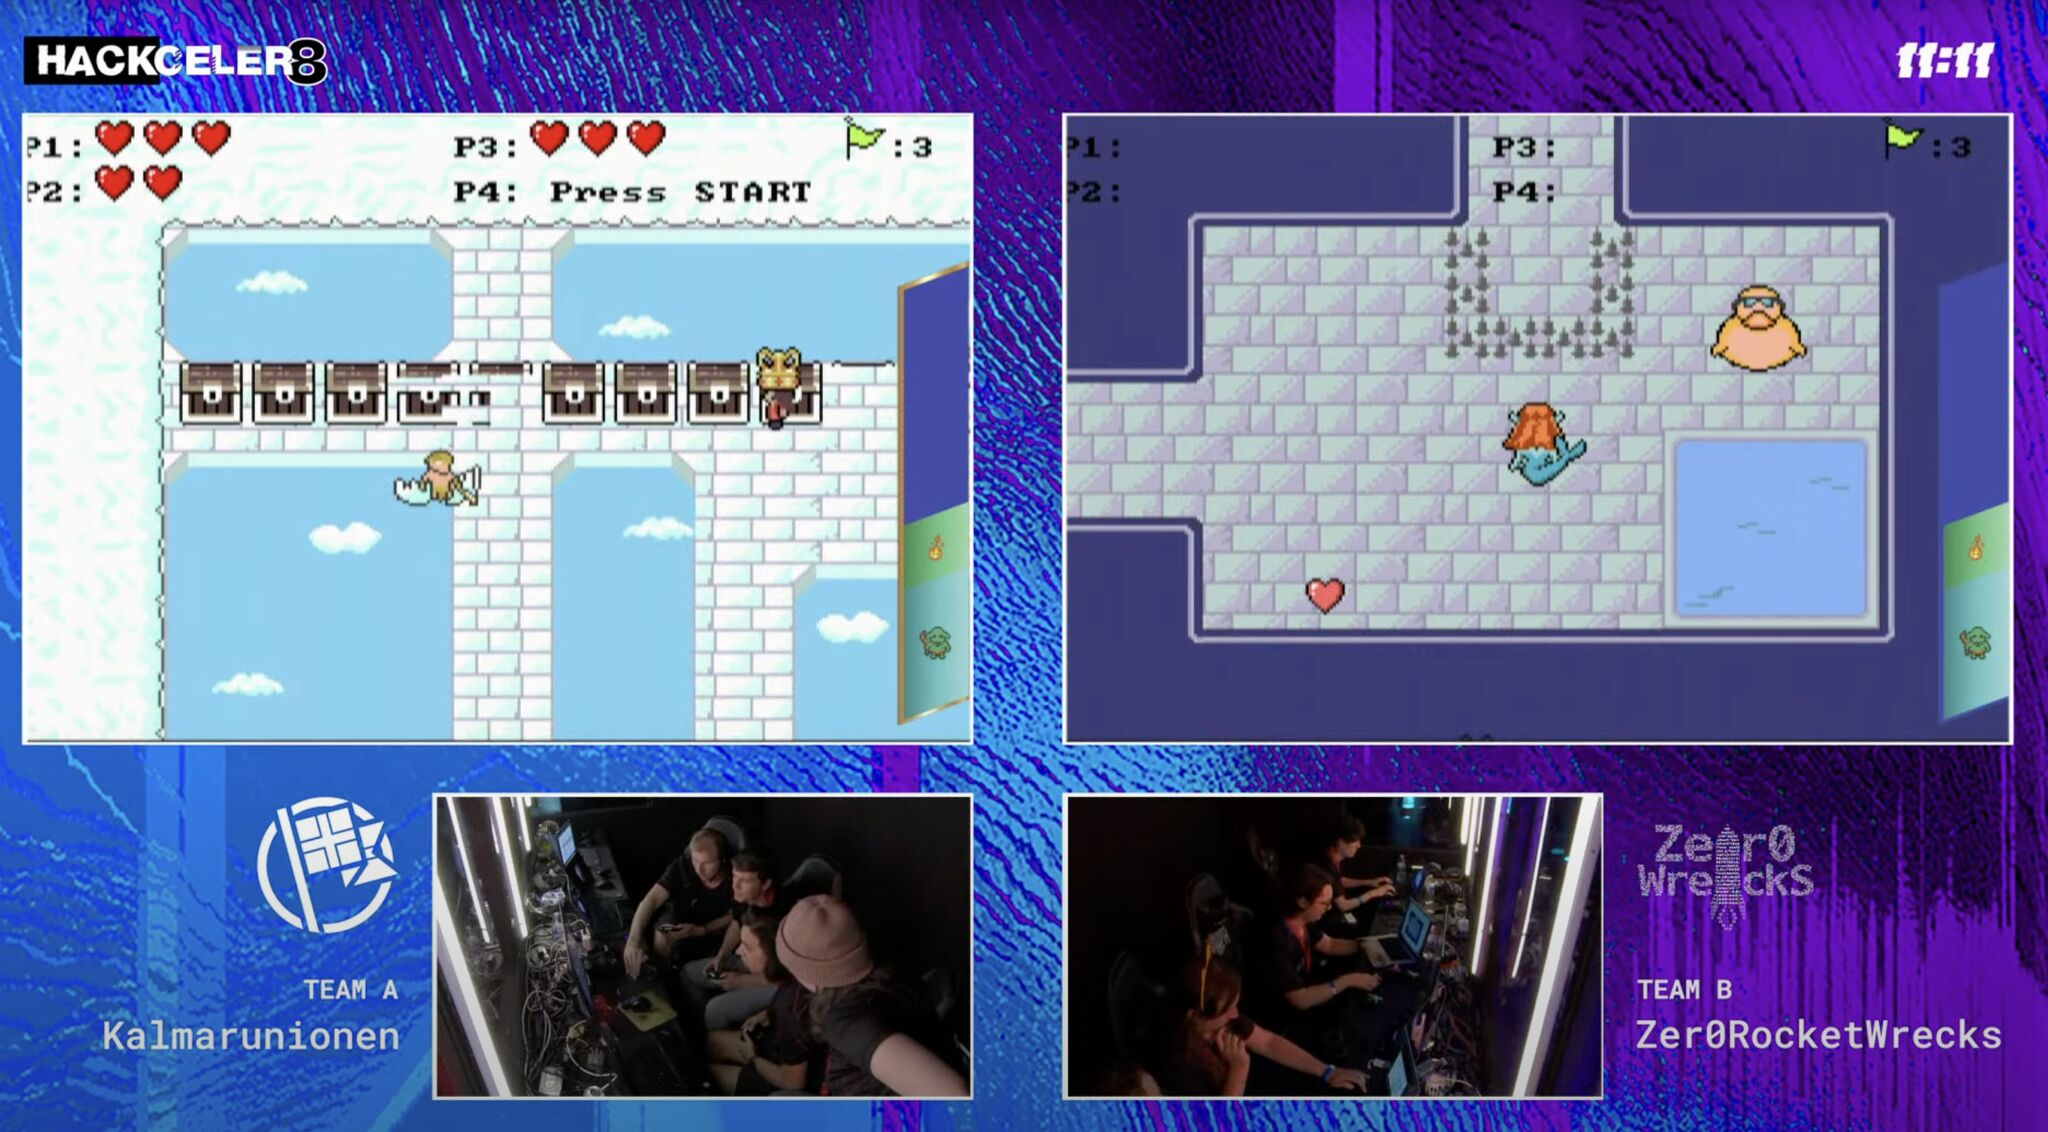
주어진 게임 바이너리에서 취약점을 찾고, 이를 이용하여 최대한 빠르게 게임을 클리어하는 형식의 대회입니다. 즉석에서 하는 글리치 스피드런이라고 생각해도 좋을 듯합니다.
게임은 인간의 직관과 본능의 결집입니다. 잘 만든 게임일 수록 유저가 본능적으로 목표와 수단을 이해하고 수행하게끔 유도합니다. LLM이 소스코드를 분석하고 게임을 텍스트로써 열심히 분석하는 와중에, 인간은 일반 상식을 통해 목표를 인지하고 풀이의 방향성을 잡아나갈 것입니다.
인간이 방향성만 제안하고 LLM이 수행하는 점은 똑같지 않냐 싶겠지만, 인간이 대부분의 전략을 스스로 인지하고 방향성을 세우며 스스로 참가하는 경험을 하는 것이 차이라 생각합니다. 이는 CTF의 (LLM과 무관하게) 고질적인 문제였던 리얼월드의 문제점과의 연결점도 일정 부분 해소하는 것이라고 생각합니다.
이런 해결책이 다른 대안에 비해 더 거부감이 없는 이유는, 인간에게 익숙한 것을 인간에게 익숙한 방식으로 LLM보다 효과적으로 접근할 수 있기 때문이라 생각합니다. LLM에게는 익숙하지 않기에(혹은 틀리지 않기 위해 모든 가능성을 검토하기 위해) 방대한 탐색 공간을 뒤져야 하지만, 사람에게는 비교적 방향성이 뚜렷하게 보이는 것이죠.
향후 더 강력한 인공지능이 등장하며 무의미해질 수도 있겠지만, 저는 지금 여기에 인간의 우위가 있다고 생각합니다.
결론
CTF는 PS나 각종 올림피아드와 마찬가지로 특정 학문에 기반한 인류의 지적 유희였습니다. LLM이 등장한 이후로는 수단을 제한하지 않는다는 점 때문에 마땅한 해결책이 보이지 않고 있습니다. 완벽한 해결책은 아니겠지만, 현재로써 Hackceler8과 같이 큰 컨텍스트를 인간의 직관으로 해소하는 방식이 유력하지 않나, 한 마디 얹어봅니다.